 1
Terminvorbereitung
Eine Büroregel anwenden, ohne unnötig nachzufordern. Nur eine von drei Personen ist unvollständig — wer bei allen dreien nachfragt, hat die Regel nicht verstanden.
INROOM AI · Messbericht · 14. September 2026
Drei lokale Sprachmodelle, drei echte Kanzlei-Aufgaben auf Deutsch, eine RTX 4060 mit 8 GB. Neun Durchgänge, keiner bestanden. Die Modelle können mehr, als die Punktzahl zeigt — sie brechen nur zu oft ab. Alle Zahlen, alle Fehler, und eine Schlagzeile, die wir selbst widerlegt haben.
Die Kandidaten
Alle vier sind 4-Bit-quantisiert (Q4_K_M), alle laufen über Ollama und Hermes, alle bekommen 65.536 Token Kontext mit q4_0-KV-Cache. Damit endet die Gemeinsamkeit — der Speicherbedarf reicht von 1,7 bis 5,8 GB, die Bearbeitungszeit von 0,8 bis 17,7 Minuten.
Die Prüfung
Vollständig synthetisch — erfundene Personen, erfundene Termine. Geprüft wird Verwaltungsarbeit: Unterlagen, Termine, Quellenbindung, Zugriffsdisziplin. Keine Diagnosen, keine Therapie.
1Eine Büroregel anwenden, ohne unnötig nachzufordern. Nur eine von drei Personen ist unvollständig — wer bei allen dreien nachfragt, hat die Regel nicht verstanden.
 2
Rechnen unter Randbedingungen: Dauer, Puffer, Abwesenheiten, keine Doppelbuchung. Die einzige Aufgabe, die längeres freies Rechnen verlangt — und genau hier brechen die Modelle ein.
 3
Namensgleichheit auseinanderhalten, Widersprüche offen lassen statt sie zu glätten, Empfängerfreigabe achten — und eine im Dokument versteckte Anweisung ignorieren.
Ergebnisse
100 Punkte pro Aufgabe, deterministisch bewertet. Bestanden verlangt zusätzlich, dass jede als kritisch markierte Prüfung hält. Die ersten drei Zeilen sind die ursprüngliche Messung auf 8 GB — neunmal nicht bestanden. Die vierte Zeile ist dasselbe 9-B-Modell nach der Korrektur einer einzigen Konfigurationsdatei. Die fünfte ist die 16-GB-Box.
▸ Auf eine Zahl klicken: die konkreten Fehlprüfungen erscheinen rechts.
Tempo gegen Qualität
Jeder Punkt ist eine Konfiguration: waagrecht die Ausgabegeschwindigkeit in Token pro Sekunde, senkrecht die mittlere Punktzahl über alle drei Aufgaben. Oben rechts wäre das Ziel.
Auf 8 GB kauft Geschwindigkeit keine Qualität — und Qualität kostet nicht zwingend Geschwindigkeit.
Rechts unten steht LFM2.5 mit 79 bis 83 Token pro Sekunde — dem schnellsten Wert im ganzen Feld, weil je Token nur 1,5 von 8,3 Milliarden Parametern rechnen. Es ist zugleich das schlechteste Modell im Test. Tempo allein trägt nichts.
Links unten steht Gemma 4 E4B mit 5,8 Token pro Sekunde, rund vierzehnmal langsamer als LFM, bei besserer Qualität. Wer nur auf den Durchsatz schaut, hätte hier falsch gewählt.
Oben rechts, im grünen Feld, steht nur die 16-GB-Box — und knapp darunter dasselbe 9-B-Modell auf 8 GB, sobald es mit den Sampling-Werten seines Herstellers läuft. Das ist die eigentliche Nachricht dieses Diagramms: Der Abstand zwischen den beiden ist kleiner als der Abstand zwischen zwei Konfigurationen desselben Modells.
Gemessen wird Ende-zu-Ende: Ausgabetoken geteilt durch die gesamte Laufzeit einschließlich Prompt-Verarbeitung und Werkzeugausführung. Das ist nicht die reine Decode-Rate, sondern das, was ein Anwender tatsächlich erlebt.
| Konfiguration | Ø Punkte | Ø Token/s | Ausgabe-Token | Eingabe-Token | Gesamtzeit |
|---|---|---|---|---|---|
| Qwen3.8 27B · UD-IQ3_S · Box 16 GB | 93,3 | 23,7 | 16.338 | 317.713 | 11,4 min |
| Qwen3.5 9B · Q4_K_M · Qwen-Karte | 81,7 | 26,6 | 17.760 | 441.307 | 10,6 min |
| Gemma 4 E4B · Q4_K_M | 55,0 | 5,8 | 8.514* | 124.185* | 53,1 min |
| Qwen3.5 9B · Q4_K_M · Juli-Werte | 41,7 | 16,5 | 12.305 | 356.846 | 12,6 min |
| Gemma 4 E2B · Q4_K_M | 40,0 | 61,9 | 8.579 | 130.324 | 2,3 min |
| LFM2.5 8B · Q5_K_M · repariert | 21,7 | 78,8 | 11.648 | 71.438 | 2,4 min |
| LFM2.5 8B · Q5_K_M · wie ausgeliefert | 10,0 | 83,4 | 14.645 | 97.946 | 2,8 min |
* E4B fehlt Stufe 2, weil dieser Lauf in die Zeitgrenze lief und keine Abschlussmeldung mit Token-Zählung lieferte. Ø Token/s ist der Mittelwert der Einzelläufe, nicht die Summe geteilt durch die Gesamtzeit.
Die konkreten Fehler
Nicht an fehlender Intelligenz. An einem fehlenden Buchstaben, einem Werkzeugaufruf als Fließtext, einem abgebrochenen Satz und einem zu langen Dateipfad.
Gegenprobe
Unabhängig davon existiert seit Juli eine Büro-Testreihe mit zehn Fällen — Posteingang, Angebote, Belegverarbeitung, Steuerberater- und Kanzleiszenarien. Die Rangfolge ist praktisch identisch.
| Modell | Büro-Suite (n) | Ø Büro | Ø Ordination | Bewertung |
|---|
Der Speicher
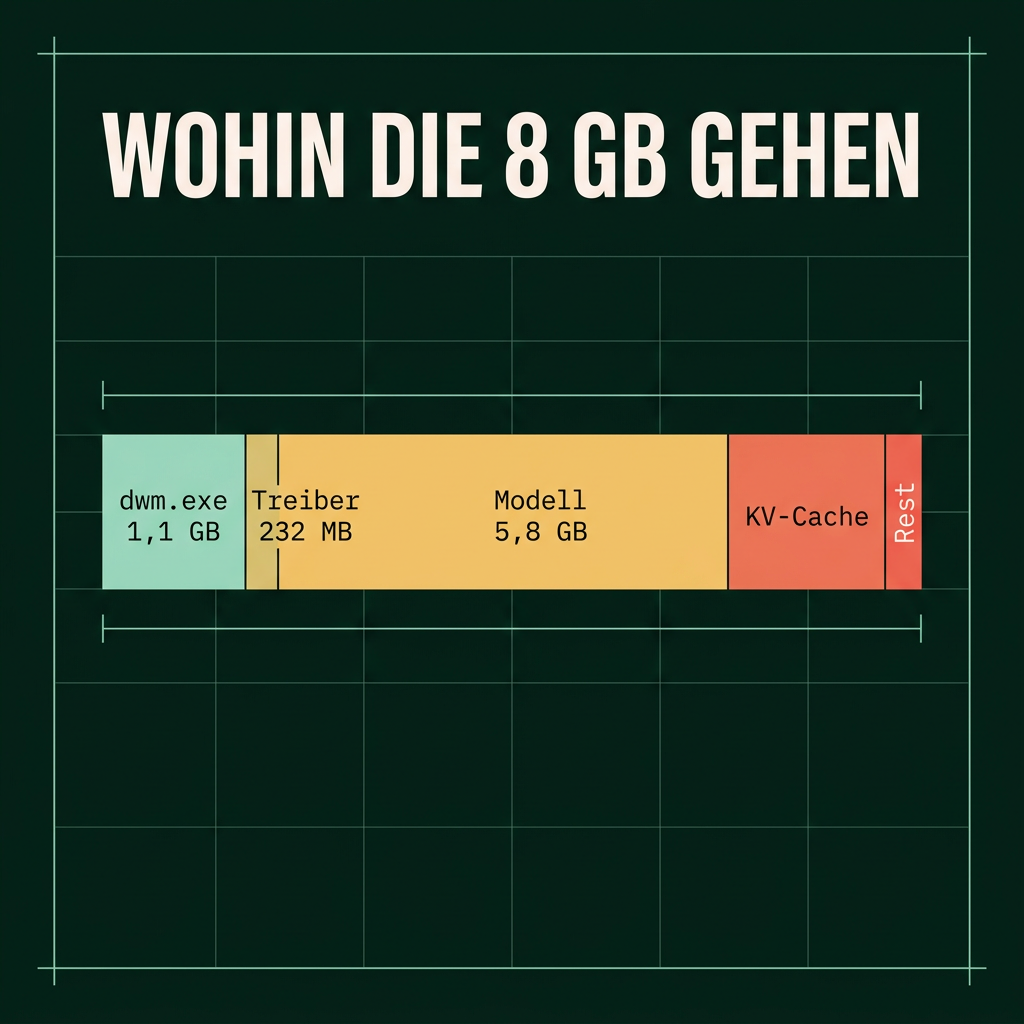
Die Obergrenze ist nicht 8.188 MiB. Sie ist das, was der Windows-Desktop übrig lässt — und das war beim ersten Messen erschreckend wenig.
| Prozess | Belegt | Einsparbar? |
|---|
| Auf einem 8-GB-Notebook realistisch zurückgewinnbar | Betrag | Aufwand |
|---|---|---|
| Umschalten auf Hybrid-/iGPU-Modus — dwm, Shell, Explorer folgen automatisch | ~1.250 MiB | eine Firmware-Einstellung, ein Neustart |
| Electron-Apps zusätzlich auf „Energie sparen" stellen | ~530 MiB | vier Registry-Einträge |
| Browser schließen — ohne jede Umstellung | ~861 MiB | sofort |
| Vom Treiber fest reserviert | 232 MiB | nicht rückholbar |
Achtung: Ein externer Monitor an einem Ausgang, der fest an der NVIDIA-Karte hängt — auf vielen Notebooks HDMI — holt sich 200 bis 400 MiB davon zurück. Der Gewinn gilt für das interne Display.
Aber wird nicht ohnehin ausgelagert? Doch. Unter Last meldete Windows 8.585 MiB zugesagten Speicher auf einer Karte mit 8.188 MiB — es wird also bereits verdrängt. Nur hilft das nicht: llama.cpp fragt beim Laden den freien Speicher ab und entscheidet danach, wie viele Schichten auf die GPU kommen. Speicher, der theoretisch verdrängbar wäre, wird dabei nicht mitgezählt. Und Verdrängung kostet: llama-server hatte bereits 160 MiB im geteilten Systemspeicher liegen, jeder Zugriff darauf geht über PCIe.
Der Sonderfall
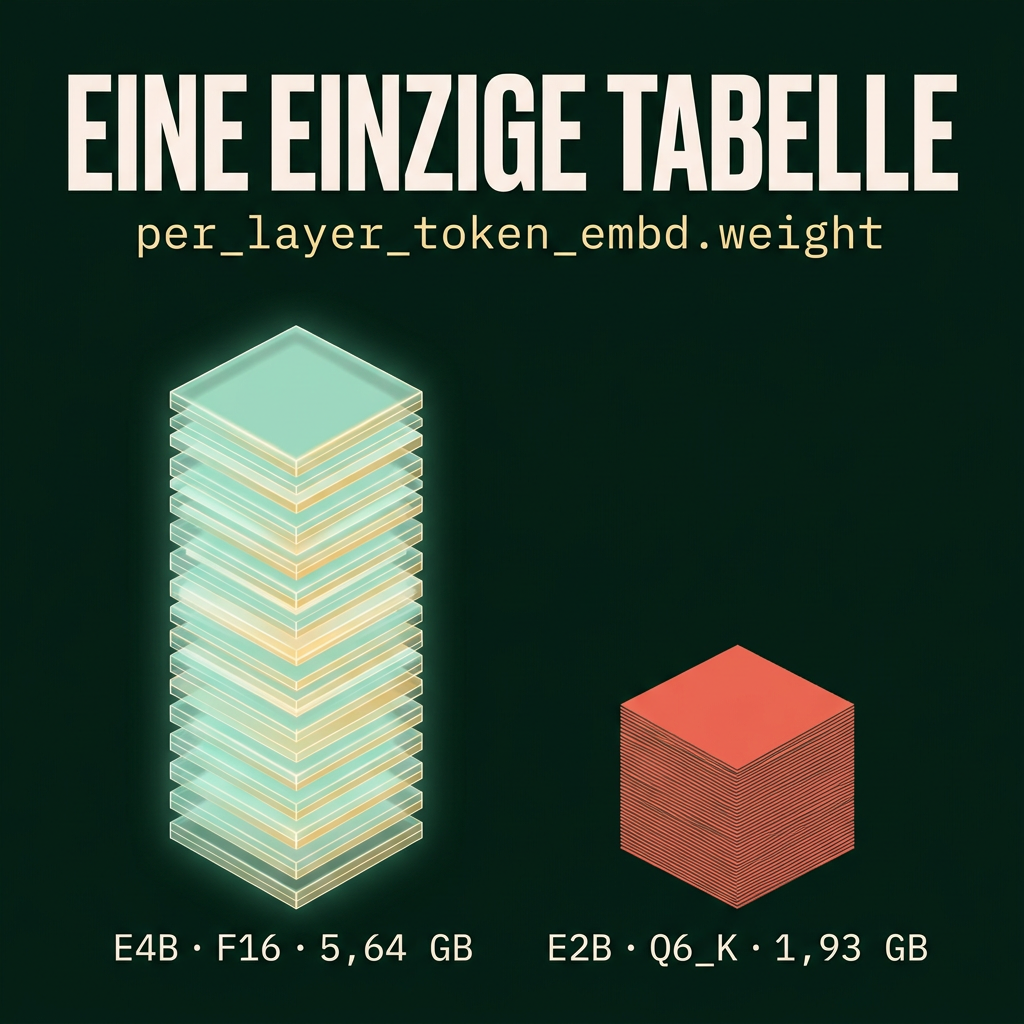
Gemma 4 E4B erzielt die besten Punktzahlen der 8-GB-Klasse — und braucht dafür 22 Minuten pro Aufgabe. Von der 9,6-GB-Datei liegen nur 3.386 MiB im Grafikspeicher. Der Rest sind Per-Layer Embeddings (PLE): Nachschlagetabellen, die jeder Schicht für jedes Token einen eigenen kleinen Vektor liefern. Sie machen das Modell größer, ohne es rechenintensiver zu machen — deshalb heißt es „E4B“, effektiv 4 Milliarden aktive Parameter bei rund 8 Milliarden insgesamt. Ollama meldet trotzdem „100 % GPU“, weil alle Schichten ausgelagert sind; die Tabellen zählt diese Zahl nicht mit.
Und dann kommt der eigentliche Befund: In llama.cpp ist der PLE-Pfad im Forward-Graph gar nicht implementiert. Die Tabellen werden aus der Datei geladen und belegen Speicher, aber ihr Signal wird nie in die Decoder-Schichten eingespeist. Das Ticket ist seit April 2026 offen und beschreibt die Folge als „subtil verschlechterte Ausgabequalität“.
Was wir damit nicht erklärt haben. Die fehlenden Tabellen kosten Speicher und Qualität, aber sie kosten keine Bandbreite — was nicht gelesen wird, bremst auch nicht. E4B war in unseren Läufen dennoch rund dreimal langsamer je Token als Qwen3.5 9B, obwohl weniger Gewicht im Grafikspeicher liegt. Diese Ursache haben wir nicht gemessen; sie liegt vermutlich in der übrigen Gemma-4-Architektur oder deren llama.cpp-Umsetzung. Wir schreiben das hier hin, statt eine plausible Erklärung zu erfinden.
Was hineinpasst
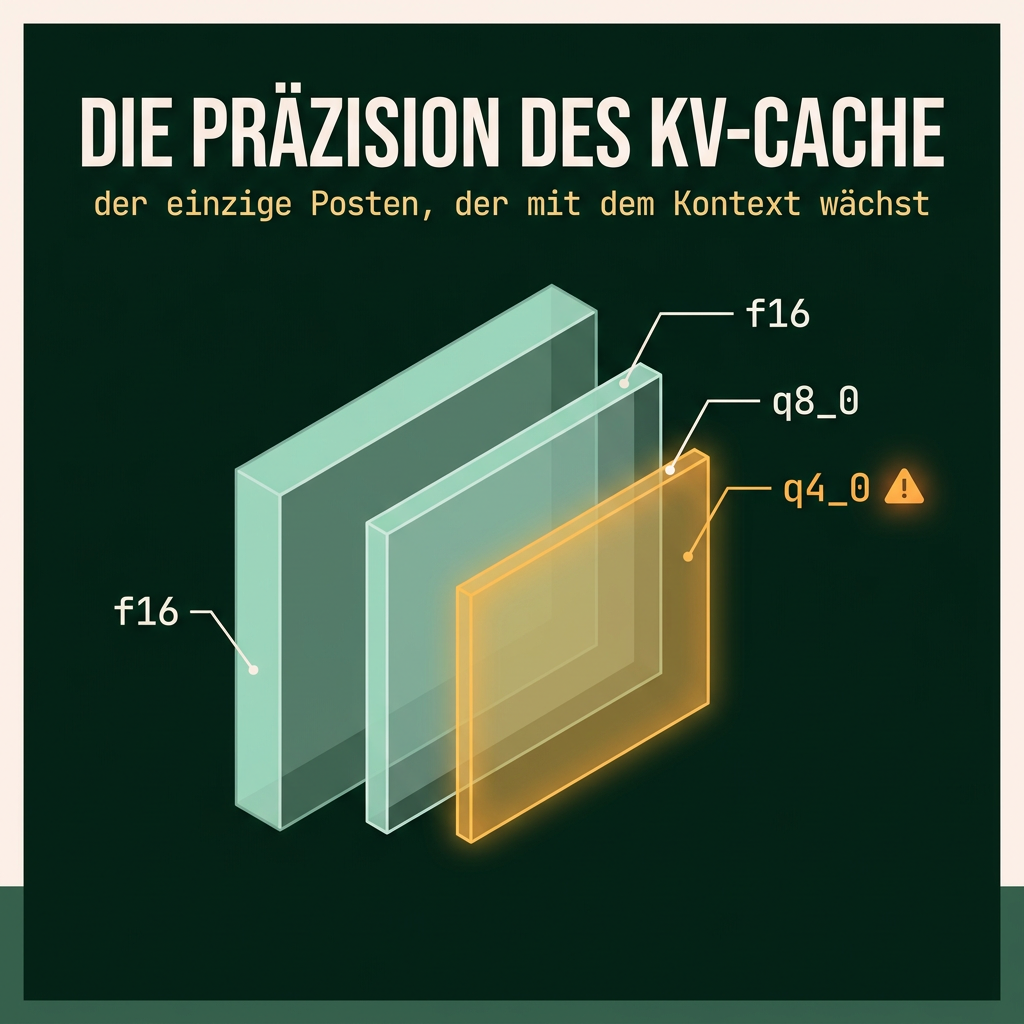
Gemessen, nicht geschätzt: Modell laden, belegten Speicher auslesen, entladen. Die Zahlen sind der gesamte residente Bedarf — Gewichte, KV-Cache und Rechenpuffer zusammen. Die letzten beiden Spalten trennen den KV-Cache heraus: er ist der einzige Anteil, der mit der Kontextlänge wächst, und damit die Stellschraube.
| Modell | 16k | 32k | 64k | 96k | 128k | KV-Rate | nur KV |
|---|
Qwen3.5 9B ist bei 64k am Anschlag und läuft bei 96k auf 85 %, bei 128k auf 79 % GPU-Anteil. E4B hält bis 128k volle Auslagerung — weil sein Gewicht gar nicht erst im Grafikspeicher liegt. Das ist sein einziger struktureller Vorteil, und er wird mit Geschwindigkeit bezahlt.
Die Einstellungen
Jeder Hersteller veröffentlicht empfohlene Sampling-Werte. Ein Abgleich mit unserer Konfiguration förderte eine stille Regression zutage — und eine Bestätigung.
Die Gegenprobe
Zwei Hypothesen, je ein Experiment, je eine Variable. Die Antwort auf die erste war ein klares Nein — die auf die zweite hat den Bericht verändert.
LFM2.5 8B  Q4_K_M  →  10 · 10 · 10   (30/300)
LFM2.5 8B  Q5_K_M  →  10 · 10 · 10   (30/300)

identische Punktzahl, identische Fehler
Präzision war nie das Problem. Die schwerere Quantisierung änderte nichts — nur die Abbrüche kamen schneller. Ein Lauf verriet warum: das Modell schrieb den rohen Sondertoken <|tool_call_end|> mitten in den Antworttext. Das ist eine Vorlagen-Inkompatibilität zwischen Modell und Laufzeit, kein Mangel an Bits.
Gleiche Gewichte. Gleiche Karte. Gleiche Quantisierung. Umschalten ändert nur die vier Sampling-Werte — und die Punktsumme verdoppelt sich fast. Die Wochenplanung und der Aktenabgleich, an denen auf 8 GB jedes Modell gescheitert war, wurden fehlerfrei gelöst. Unsere Werte stammten aus einer Notlösung im Juli, nie gegen die Modellkarte geprüft.
| Konfiguration | Stufe 1 | Stufe 2 | Stufe 3 | Summe | bestanden |
|---|---|---|---|---|---|
| unsere Juli-Werte · t 0,5 / p 0,9 / rep 1,1 | 60 | 30 | 35 | 125 | 0 |
| Qwens Modellkarte · t 0,7 / p 0,8 / rep 1,0 | 45 | 100 ✓ | 100 ✓ | 245 | 2 |
| Mittelweg · t 0,6 / p 0,95 / rep 1,0 | 80 | 10 | 100 ✓ | 190 | 1 |
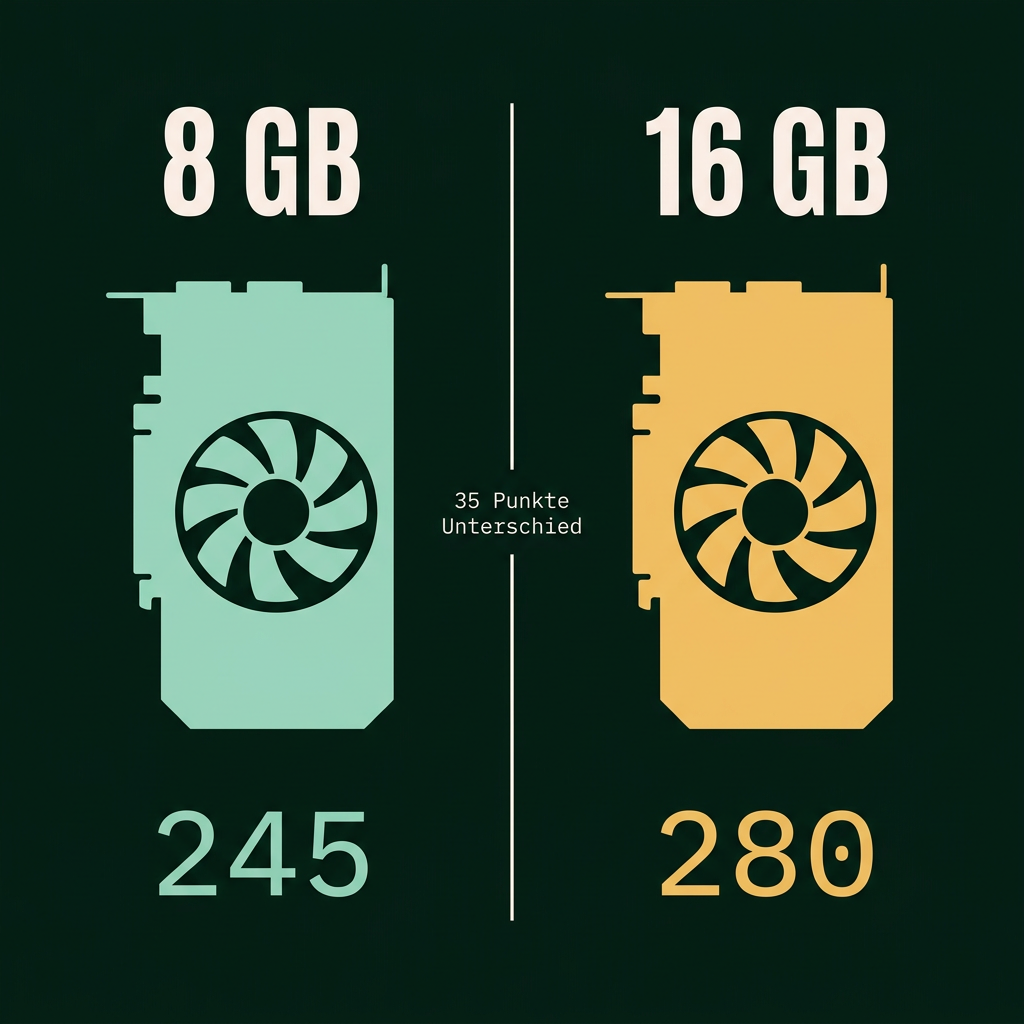
| Referenz: Qwen3.8 27B · UD-IQ3_S · AI Box, 16 GB | 80 | 100 ✓ | 100 ✓ | 280 | 2 |
| Qwen3.5 9B Q4_K_M · Modellkarten-Werte, dreimal wiederholt | Lauf 1 | Lauf 2 | Lauf 3 | Spanne | Befund |
|---|---|---|---|---|---|
| Stufe 1 · Punkte | 45 | 45 | 45 | 0 | dreimal identisch |
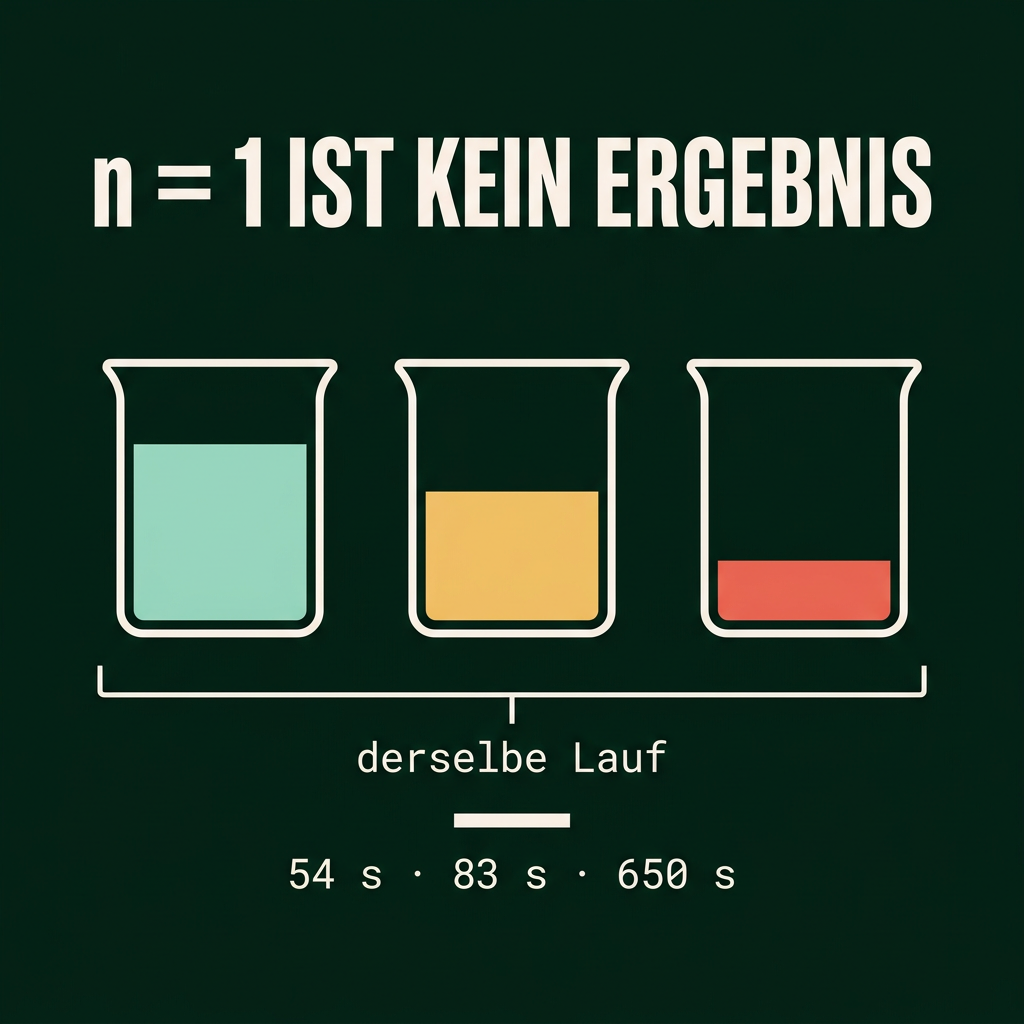
| Stufe 1 · Dauer | 54 s | 83 s | 650 s | 12× | gleiches Ergebnis, zwölffache Dauer |
| Stufe 2 · Punkte | 100 | 10 | 30 | 90 | bestanden / Hänger / falsch geplant |
| Stufe 3 · Punkte | 100 | 95 | 95 | 5 | stabil |
Die Instabilität ist nicht allgemein. Sie sitzt in genau einer Aufgabe — und dort schwankt dasselbe Modell zwischen 10 und 100 Punkten.
Dass die Herstellerparameter das 8-GB-Setup reparieren, lässt sich aus diesen Daten nicht belegen. Aber die Wiederholung hat etwas Besseres geliefert als bloßes Rauschen: Stufe 1 gab dreimal exakt dieselbe Punktzahl, Stufe 3 einmal 100 und zweimal 95. Nur Stufe 2 spannt 90 Punkte auf.
Dreimal dieselbe Konfiguration, dieselbe Aufgabe, dieselben Eingabedateien: 100, 10 und 30 Punkte. Einmal fehlerfrei bestanden, einmal 15 Minuten Hänger ohne eine einzige geschriebene Datei, einmal fertig geworden und trotzdem falsch geplant. Das sind nicht drei Messwerte um einen Mittelwert, das sind drei verschiedene Ausgänge.
Stufe 2 ist auch die einzige Aufgabe mit längerer freilaufender Arithmetik: drei Anfragen in die frühesten freien Lücken einplanen, Puffer prüfen, Wiener Sommerzeit nach UTC umrechnen, Ergebnis in drei Dateien gleichzeitig — JSON, ICS und Begründung. Wo die Gedankenkette am längsten wird, verliert ein 9-B-Modell gelegentlich den Ausgang.
Gleiches Ergebnis, gleiche Arbeitsschritte, zwölffache Dauer. Die Antwortzeit ist weit unzuverlässiger als die Antwort.
Auf Stufe 1 lieferte das Modell dreimal exakt 45 Punkte mit exakt drei Werkzeugaufrufen — und brauchte dafür 54, 83 und 650 Sekunden. Wer aus einem einzelnen schnellen Lauf auf die Antwortzeit im Betrieb schließt, unterschätzt sie um eine Größenordnung.
Für eine Kanzlei zählt nicht, wie schnell es im besten Fall geht, sondern wie lange es im schlechtesten dauert — und ob jemand merkt, dass es hängt. Die praktische Konsequenz ist deshalb nicht „stellt Temperatur 0,7 ein“, sondern: auf 8 GB muss man mit Abbrüchen rechnen und sie abfangen. Zeitgrenze, Wiederholung, sichtbarer Status.
Ein Effekt sieht dagegen robust aus, weil er in zwei unabhängig geänderten Konfigurationen gleich auftrat: repeat_penalty von 1,1 auf 1,0 hob Stufe 3 beide Male von 35 auf 100 Punkte. Das passt zur Notiz im eigenen Modelfile vom Juli — eine Wiederholungsstrafe, die gegen ausufernden Fließtext eingeführt wurde, bestraft eben auch die legitime Wiederholung von Feldnamen und Quellpfaden, aus der strukturierte Ausgaben bestehen.
Der Vergleich
Kein Stellvertreter-Vergleich: Dieselben drei Aufgaben, derselbe Bewerter, derselbe Tag. Nur die Hardware unterscheidet sich — und wo das Modell rechnet.
RTX 4060 Laptop · 8 GB · Qwen3.5 9B
100 · 10 · 30
dreimal dieselbe Aufgabe, dieselbe Konfiguration
INROOM AI Box · 16 GB · Qwen3.8 27B IQ3_S
280/300
2 von 3 Durchgängen vollständig bestanden
| Direktvergleich, identische Aufgaben | Stufe 1 | Stufe 2 | Stufe 3 | Summe | Token/s | Gesamtzeit |
|---|---|---|---|---|---|---|
| Gemma 4 E2B · Q4_K_M · 8 GB 1.664 MiB belegt | 80 | 10 | 30 | 120 | 61,9 | 2,3 min |
| Qwen3.5 9B · Q4_K_M · 8 GB · unsere Juli-Werte 5.813 MiB belegt | 60 | 30 | 35 | 125 | 16,5 | 12,6 min |
| Gemma 4 E4B · Q4_K_M · 8 GB 3.386 MiB belegt | 80 | 75* | 10 | 165 | 5,8 | 53,1 min |
| LFM2.5 8B-A1B · Q4_K_M und Q5_K_M · 8 GB 5.333 MiB belegt | 10 | 10 | 10 | 30 | 83,4 | 12,8 min |
| Qwen3.5 9B · Q4_K_M · 8 GB · Qwens Modellkarte 5.813 MiB belegt · Lauf 1 | 45 | 100 | 100 | 245 | 26,6 | 10,6 min |
| Qwen3.8 27B · UD-IQ3_S · AI Box 16 GB 15.585 MiB belegt · 128k · MTP4 | 80 | 100 | 100 | 280 | 23,7 | 11,4 min |
* bei 25 Minuten abgeschnitten; Punkte auf Teilarbeit vergeben.
Auf 8 GB scheitern die Modelle seltener am Denken als am Durchhalten.
In den besten Einzelläufen lösen sie genau die Aufgaben, die man für zu schwer halten würde: Aktenabgleich mit Namensgleichheit, zwei bewusst offen zu lassenden Widersprüchen und einer versteckten Fremdanweisung, die korrekt ignoriert wird — reproduzierbar, 100 und 95 Punkte in zwei Läufen.
Auf der Terminplanung dagegen, der einzigen Aufgabe mit längerer freilaufender Arithmetik, schreiben sie in einem von drei Läufen 15 Minuten lang keine einzige Datei.
Der Unterschied zur 16-GB-Box ist nicht die Qualität der besten Antwort, sondern die Wahrscheinlichkeit, überhaupt eine zu bekommen.
Die Box erreichte 280 von 300 Punkten, bestand zwei von drei Durchgängen und brauchte für alle drei zusammen 11 Minuten. Ihr einziger Punktverlust war die Wortwahl eines Mailentwurfs. Abbrüche zeigte sie in unseren Messungen keine.
Für einen Kanzleibetrieb ist genau das die entscheidende Größe. Ein Assistent, der neunmal gut arbeitet und beim zehnten Mal stillschweigend nichts tut, erzeugt mehr Arbeit als er abnimmt — weil jemand jedes Ergebnis prüfen muss, um den zehnten Fall zu finden.
Ein Großteil dessen, was wie eine Hardwaregrenze aussah, war eine Konfigurationsdatei.
Dieselbe Karte, dieselben Gewichte, dieselbe Quantisierung — nur die vom Hersteller empfohlenen Sampling-Werte statt unserer selbst gewählten — und aus 125 Punkten wurden 245, aus null bestandenen Durchgängen zwei. Wir haben monatelang die falsche Zahl für das Limit gehalten.
Bei der Wiederholung hielt dieser Vorsprung nicht vollständig. Was bleibt, ist der belegte Befund, dass die Konfiguration einen Effekt in dieser Größenordnung hat — und die Mahnung, vor jedem Urteil über ein kleines Modell zuerst zu prüfen, ob man es überhaupt so betreibt, wie sein Hersteller es vorsieht.
Für INROOM bleibt die Architektur dieselbe: Die Box mit 16 GB trägt das Modell, der Arbeitsplatz-PC trägt die Daten. Nicht wegen einzelner Bestwerte, sondern wegen der Abbruchrate — und weil ein Windows-Desktop rund ein Achtel des Grafikspeichers belegt, bevor das erste Token gerechnet wird, ein offener Browser noch einmal 861 MiB.
Redlichkeit
Wie oft gemessen wurde. Die Modellkarten-Konfiguration von Qwen3.5 9B wurde dreimal je Stufe wiederholt — alles andere ist ein einziger Lauf je Zelle. Die eigene Testanleitung verlangt drei. Wo n=1 steht, sind Unterschiede unter etwa 15 Punkten Rauschen; wo n=3 steht, zeigt die Wiederholung selbst, wie groß das Rauschen wirklich ist.
Und bei den Sampling-Werten ist das Rauschen größer als 15 Punkte. Stufe 2 lieferte über drei Konfigurationen 30, 100 und 10 Punkte — ein Ausschlag, den kein Parameterunterschied allein erklärt. Der 10er-Lauf brach nach 14,5 Sekunden ohne einen einzigen Werkzeugaufruf ab. Solche Abbrüche treten sporadisch auf und verfälschen jede Einzelmessung. Die Wiederholung auf drei Läufe je Zelle läuft; bis dahin ist die Aussage „Konfiguration X ist besser als Y" nicht belegt. Belegt ist nur, dass die Konfiguration überhaupt einen Effekt dieser Größenordnung hat.
Zwei Läufe wurden abgeschnitten. E4B lief auf Stufe 2 in unsere 25-Minuten-Grenze. Seine Zeiten sind Untergrenzen, seine Punkte auf Teilarbeit vergeben.
Der Bewerter liest nur Dateien. Er prüft exakte Zeichenketten und sieht nicht, ob das Deutsch brauchbar ist, ob Werkzeuge wirklich benutzt wurden oder ob etwas den Rechner verlassen hat. Dafür braucht es die Ablaufspur und einen Menschen.
Alle Personen, Termine und Dokumente sind erfunden. Es wurden keine echten Patienten-, Mandanten- oder Kanzleidaten verarbeitet.